Входит в Реестр
российского ПО

Содержание
- Зачем ИИ нужен в информационной безопасности
- Задачи, которые решает искусственный интеллект в ИБ
- Как ИИ применяется в DLP и защите информации
- ИИ в мониторинге рабочего времени и цифровой активности сотрудников
- Ограничения и риски: что ИИ не заменяет
- Сравнение подходов: правила, машинное обучение и гибридная схема
- Как выбрать решение: практические критерии
- Практические рекомендации по внедрению
- Что будет с ИИ в ИБ дальше
- Частые ошибки при работе с ИИ в информационной безопасности
- Чек-лист: готова ли компания к ИИ-детекту
- Итоги: что запомнить о применении ИИ в информационной безопасности
- FAQ
Развернуть
Попробовать бесплатно ИНСАЙДЕР
Протестируйте систему мониторинга за 14 дней с поддержкой нашего специалиста и узнайте, чем заняты ваши сотрудники на самом деле.
ИИ в информационной безопасности: где реально работает и что пока не заменяет
Разбираем, какие задачи в информационной безопасности ИИ закрывает уже сейчас: фильтрация сотен событий в сутки, поиск аномалий в поведении пользователей, работа в DLP и мониторинге цифровой активности. Отдельно — где модель ошибается и почему финальное решение остаётся за специалистом.
Специалист по информационной безопасности открывает утром консоль SIEM и видит несколько сотен новых событий за ночь. Часть из них — реальные попытки входа с необычных адресов, часть — обновление антивирусных баз на сервере, часть — сканирование, которое давно известно и закрыто на периметре. Пока аналитик разбирает этот поток вручную, настоящее событие может ждать своей очереди шестым по счёту. Именно на этом участке чаще всего и обсуждают применение искусственного интеллекта в информационной безопасности: не как замену специалиста, а как способ разгрузить его от рутины и ускорить реакцию.
При этом ожидания вокруг темы сильно расходятся с реальностью. Одни считают ИИ панацеей и ждут, что модель сама найдёт утечку и заблокирует нарушителя. Другие относятся к нему как к маркетинговой надстройке над привычными правилами. Правда лежит между этими полюсами: машинное обучение в ИБ действительно меняет приоритизацию событий, но работает только в связке с процессами, данными и человеком, который принимает решение.
Основные термины и тематические понятия
Искусственный интеллект (ИИ) в ИБ — применение методов машинного обучения и анализа больших данных для обнаружения угроз, сортировки событий и подготовки решений по инцидентам.
Машинное обучение (ML) — подход, при котором модель выявляет закономерности на исторических данных, а не действует по заранее описанному правилу.
SIEM — система сбора и корреляции событий безопасности из разных источников, которая формирует единый поток для анализа.
SOAR — платформа автоматизации реагирования: запускает типовые действия по инциденту по заранее заданному сценарию.
UEBA — аналитика поведения пользователей и устройств, которая ищет отклонения от привычной для конкретного сотрудника нормы.
DLP-система — средство контроля передачи информации, которое отслеживает, какие данные и куда уходят за пределы контура.
Инцидент информационной безопасности — зафиксированное событие, требующее проверки: он указывает на возможную проблему, но сам по себе ничего не доказывает.
Ложное срабатывание — сигнал системы, который после проверки оказался безобидным действием.
Шум алертов — избыточный поток однотипных уведомлений, в котором теряются значимые события.
Аномалия — отклонение в поведении пользователя, устройства или трафика от обычного для них шаблона.
Объяснимость модели — способность системы показать, на основании каких признаков она отнесла событие к подозрительным.
Человек в контуре принятия решений — принцип, при котором финальную оценку и действия по инциденту выполняет специалист, а не автоматика.
Суть за минуту
ИИ в информационной безопасности силён там, где данных много, а ручного времени мало: он сортирует поток событий, ищет отклонения в поведении и помогает быстрее добраться до значимого инцидента.
Он не заменяет политику безопасности, не отменяет проверку и не гарантирует обнаружение угрозы. Решение по-прежнему принимает человек, а польза модели напрямую зависит от качества данных и настроенных процессов.
Зачем ИИ нужен в информационной безопасности
Объём данных в защите информации растёт быстрее, чем штат службы безопасности. Корпоративная сеть, облачные сервисы, рабочие станции, мобильные устройства и десятки средств защиты ежедневно производят события, которые нужно собрать, сопоставить и оценить. Человек физически не успевает прочитать всё, поэтому реальный выбор аналитика — не «разобрать весь поток», а «успеть посмотреть хотя бы часть».
Второй источник давления — скорость атаки. Пока событие ждёт разбора, данные уже ушли или учётная запись уже использована. Здесь и проявляется сильная сторона подхода: упреждающий анализ позволяет найти слабые сигналы раньше, чем инцидент станет очевидным. Модель не «видит» угрозу целиком, но она способна заметить отклонение, которое не попало ни под одно статическое правило.
Третий фактор — стоимость внимания. Каждый ложный вызов отнимает у специалиста время и притупляет бдительность: после сотого безобидного уведомления человек начинает просматривать их быстрее и внимательнее уже не читает. Автоматическая сортировка помогает вернуть концентрацию на то, что действительно требует решения.
И, наконец, дефицит кадров. Специалистов по безопасности не хватает, а часть их рабочего времени уходит на однотипные операции: сверку адресов, проверку хэшей, чтение однотипных логов. Именно эти операции автоматизируются проще всего — при условии, что их результат затем проверяет человек.
Задачи, которые решает искусственный интеллект в ИБ
Набор прикладных задач, где модели применяются сегодня, довольно устойчив. Он охватывает и технический уровень — файлы, трафик, вредоносное ПО, — и поведенческий, связанный с действиями людей в корпоративной среде. Ниже — три направления, которые чаще всего встречаются в реальной эксплуатации.
Важно различать, что именно делает модель. Нейросеть для обнаружения угроз не «понимает» замысел атакующего: она сравнивает наблюдаемое с тем, что видела в обучающих данных, и оценивает степень отклонения. Поэтому каждое направление ниже — это инструмент приоритизации, а не приговор конкретному событию.
Обнаружение вредоносных программ и анализ файлов
Классическая сигнатура надёжна там, где образец уже известен. Против новой сборки, которой нет в базе, она не работает. Здесь на помощь приходит статический анализ PE-файлов: модель изучает заголовок исполняемого файла, таблицы импорта, секции, признаки упаковки и другие структурные особенности, а затем относит образец к классу «подозрительный» или «обычный» без запуска.
Для обучения такой модели нужен подготовленный набор данных: размеченная коллекция вредоносных и чистых образцов. Чем полнее коллекция и чем аккуратнее разметка, тем меньше модель путается. Обнаружение вредоносных программ на этом уровне дополняет антивирус, а не заменяет его: сигнатура быстро закрывает известное, модель помогает заметить модифицированное.
Классификация трафика и защита веб-среды
Сетевой поток удобен для машинного анализа: он объёмный, структурированный и хорошо поддаётся агрегации. Классификация трафика позволяет отделить типовые сессии сотрудников от нетипичных для их роли обращений — например, регулярных соединений на незнакомый внешний адрес или передач необычного объёма в нерабочее время. Такие сигналы не обязательно означают атаку, но они заслуживают проверки.
Отдельная задача — защита веб-среды: распознавание попыток эксплуатации уязвимостей в запросах к корпоративным приложениям, выявление автоматизированного перебора и необычных сценариев обращения к формам. Модель учится на исторических журналах и помогает отсечь часть атак, для которых ещё нет точного правила. Ограничение то же, что и везде: новый класс атак, не похожий на прошлые, может остаться незамеченным.
Поиск аномалий в цифровой активности
Аномалия — это не нарушение, а отклонение. Сотрудник, который обычно работает с 9 до 18 в офисе, вдруг заходит в систему в три часа ночи с домашнего адреса; бухгалтер, который никогда не обращался к каталогу проектной документации, открывает его впервые; на рабочей станции появляется программа, которой в этой группе не было. Каждый из этих эпизодов может иметь простое объяснение, но именно на их пересечении часто и обнаруживается проблема.
Поиск аномалий в цифровой активности опирается на базовую линию — типовое поведение конкретного пользователя или группы. Чем больше контекста у модели, тем точнее она отделяет редкое, но безобидное от редкого и опасного. Без такого контекста любая нетипичная активность выглядит подозрительной, и функция превращается в генератор шума.
Как ИИ применяется в DLP и защите информации
Контроль утечек — та область, где значение имеет не столько событие, сколько смысл документа. Файл, который сотрудник отправил внешнему адресату, может быть рабочим согласованием, а может быть клиентской базой. Отличить одно от другого по расширению или размеру невозможно, поэтому исторически DLP и опирались на правила, а правила требовали ручной настройки под каждый тип данных.
Машинное обучение меняет логику работы с контентом. Вместо списка из сотен шаблонов система учится распознавать сам тип документа — по структуре, составу полей, стилю и контексту. Это не отменяет точных правил для самых чувствительных данных, но снимает с администратора значительную часть работы по их описанию.
Классификация документов и контента
Классификация документов позволяет присвоить файлу категорию автоматически: договор, финансовый отчёт, техническое задание, кадровый документ, клиентская выгрузка. Дальше эта категория становится основанием для политики: одна категория уходит только внутри контура, другая допускает отправку контрагентам, третья требует согласования. Администратор настраивает правила для классов, а не для каждого файла.
У классификации есть цена. Модель ошибается на новых форматах, на документах со смешанным содержанием, на нетипично оформленных файлах. Поэтому в чувствительных сценариях результат классификации стоит рассматривать как основание для уточнения, а не как окончательный вердикт. Если категория определена неверно, лучше, чтобы это выяснилось на проверке, чем после отправки.
Контекстные политики вместо правил по ключевым словам
Правило по ключевому слову простое и предсказуемое: нашло слово «зарплата» — подняло инцидент. На практике оно срабатывает на шаблоне трудового договора, на переписке о больничном и на методичке кадровика. Уточнять такое правило приходится списками исключений, и со временем исключений становится больше, чем самих правил.
Контекстные политики оценивают ситуацию целиком: кто отправитель, какая у него роль, что за документ, куда и каким каналом он уходит, как это соотносится с обычной практикой отдела. Тот же файл, отправленный штатным сотрудником кадровой службы по рабочему адресу, и он же, отправленный на личную почту в пятницу вечером, получают разную оценку. Это заметно снижает шум алертов и повышает доверие к системе со стороны бизнеса.
Однако контекстные политики сложнее объяснить и сложнее проверить. Когда сигнал сформировала модель, а не правило, администратору нужно понимать основания. Без этого невозможно ни отладить политику, ни ответить на вопрос сотрудника, почему его действие попало в список.
ИИ в мониторинге рабочего времени и цифровой активности сотрудников
Часть инцидентов видна не на периметре, а внутри: на рабочей станции, в почте, в браузере, в файловых операциях. Именно там остаётся цифровой след, по которому можно восстановить последовательность действий. Мониторинг цифровой активности собирает эти данные — программы и сайты, активное и фоновое использование, поисковые запросы, снимки экрана, системные события — а аналитический слой помогает найти в них значимое.
Здесь применение ИИ осторожнее, чем в детекте трафика, и это оправданно. Данные о поведении сотрудника чувствительны, а цена ошибки выше: неверно истолкованный сигнал способен испортить рабочую репутацию человека. Поэтому такие системы чаще работают как источник контекста для расследования, а не как автоматический арбитр.
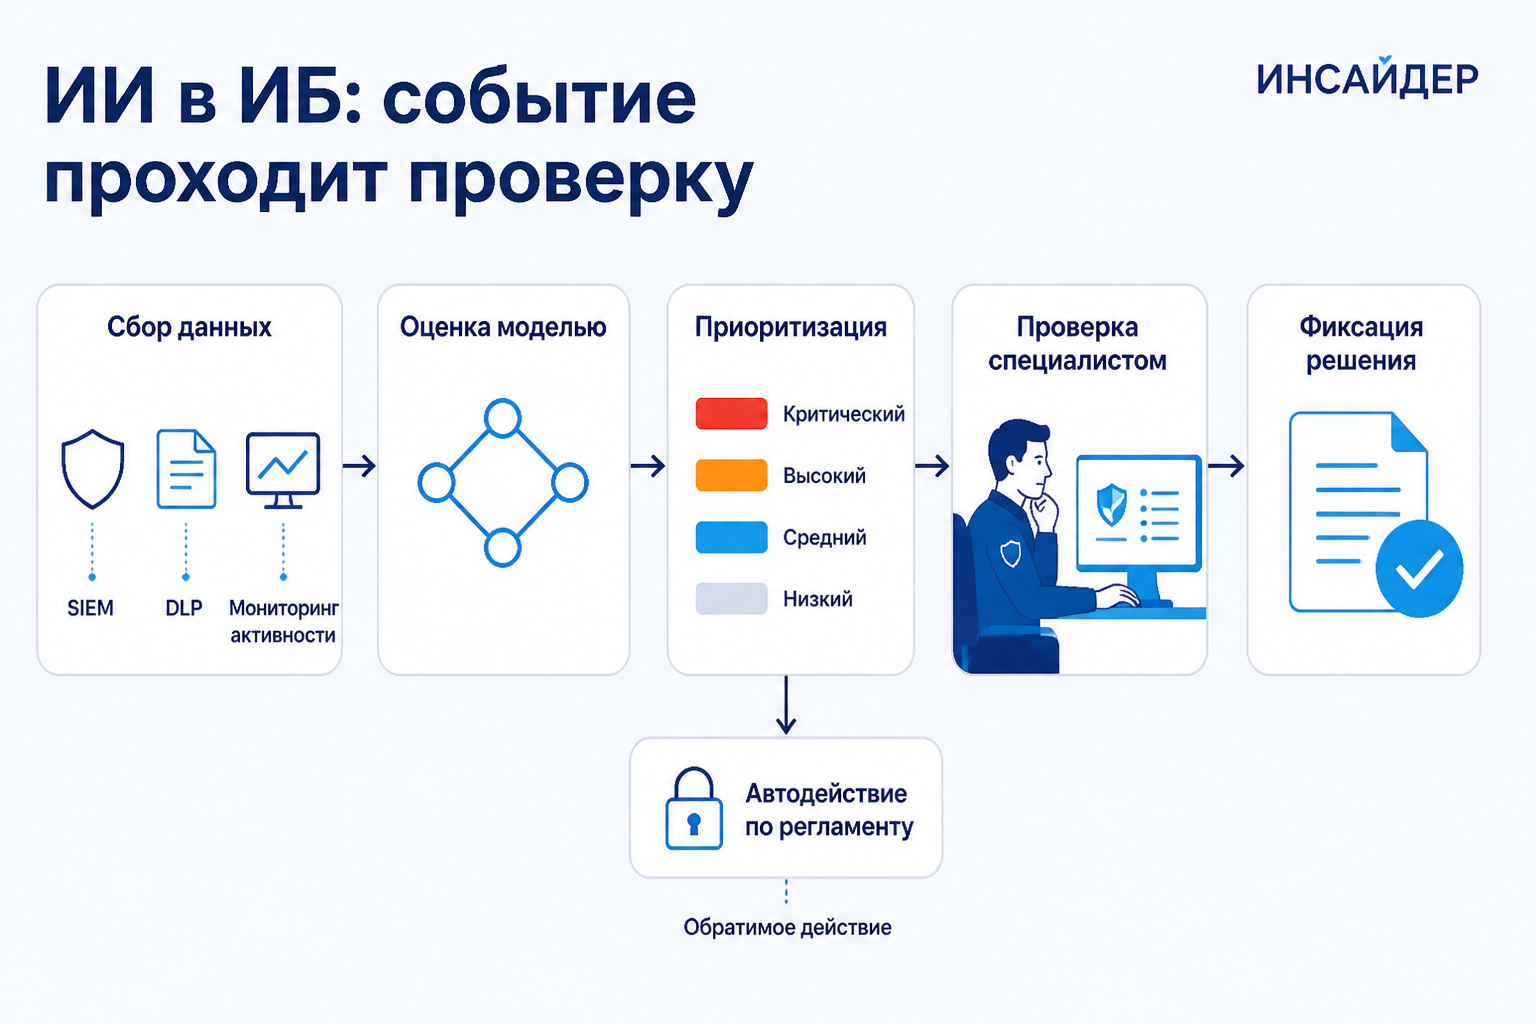
Типовые сценарии выглядят так. Руководитель или служба безопасности задаёт политику: например, появление в корпоративной сети нежелательного программного обеспечения, регулярные обращения к ресурсам, не связанным с задачами роли, повторяющиеся попытки передачи информации на внешние адреса. Система формирует автоматические инциденты по этим правилам, а модель помогает отсортировать их по значимости и собрать связанные события в одну хронологию. Специалист открывает карточку и видит не отдельное уведомление, а последовательность: что было до, что после, какие программы и ресурсы участвовали.
Второй сценарий — работа с исключениями. У большинства сотрудников активность укладывается в ожидаемый профиль, и тратить время на её просмотр бессмысленно. Модель помогает выделить тех, чьё поведение устойчиво отличается от нормы группы, и перевести контроль из режима сплошного наблюдения в режим работы по отклонениям. Для руководителя это означает меньше ручных проверок, для специалиста — меньше поводов открывать всё подряд.
Третий сценарий — поддержка расследования. Когда инцидент уже произошёл, важно быстро собрать факты: кто, когда, с какого устройства, какие файлы, какие адреса. Аналитика цифровой активности сокращает время на эту сборку, потому что данные уже лежат в единой системе, а не разбросаны по журналам разных средств.
Системы мониторинга цифровой активности, такие как ИНСАЙДЕР, в этой схеме занимают позицию источника пользовательского контекста: они показывают хронологию дня, программы и сайты, снимки экрана, поисковые запросы и инциденты по настроенным правилам. Это дополнение к SIEM и DLP, а не их замена — в расследовании нужен и технический след на периметре, и картина того, что происходило на рабочем месте.
Семь правил, без которых данные мониторинга вводят в заблуждение
Аналитика поведения сотрудников опасна тем, что выглядит убедительно. График продуктивности и список инцидентов создают ощущение объективности, хотя за ними стоят ограничения измерения. Ниже — правила, которые стоит держать в явном виде до того, как данные попадут в управленческое решение.
- Цифровая активность не равна результату. Показатели говорят о том, как использовались рабочие инструменты, а не о том, какая задача решена.
- Простой требует контекста. Отсутствие активности может означать совещание, звонок, работу с бумагами или разговор с клиентом вне компьютера.
- Фоновая программа — не активная работа. Открытое приложение в трее не значит, что человек в нём что-то делает.
- Снимок экрана — контекст момента. Он помогает восстановить картину, но не доказывает ни качество работы, ни умысел.
- Автоматический инцидент — сигнал для проверки. Он не является доказательством нарушения, утечки или мошенничества.
- Оценка складывается из нескольких источников. Данные мониторинга сопоставляют с задачами, сроками, качеством и показателями из профильных систем.
- Решение принимает уполномоченный человек. Система показывает факты, но не выносит управленческое суждение.
Эти правила не ослабляют мониторинг, а делают его пригодным для использования. Без них первый же разбор спорной ситуации упрётся в вопрос «а что, собственно, доказывает этот график», и доверие к системе упадёт быстрее, чем она успела принести пользу.
Получите
демодоступ
демодоступ
Заполните форму и оцените
возможности ИНСАЙДЕР
возможности ИНСАЙДЕР
Ограничения и риски: что ИИ не заменяет
Разговор об ограничениях обычно сводят к фразе «модель иногда ошибается». Это правда, но неполная. Ограничения у подхода системные: они касаются данных, на которых модель училась, юридических рамок работы с данными сотрудников и самой природы решения по инциденту. Разберём три группы, которые чаще всего недооценивают при внедрении.
Ещё одно ограничение стоит назвать отдельно. Модель не знает контекста, которого нет в данных: что сотрудник согласовал отпуск, что отдел переехал, что у клиента сменился юридический адрес. Любая автоматическая оценка опирается на прошлое и на настройки, а не на разговор в кабинете. Поэтому чем чувствительнее сценарий, тем важнее человек, который этот контекст добавляет.
Ложные срабатывания
Ложные срабатывания — не дефект, а неизбежное свойство любого детекта. Правило срабатывает на совпадение, модель — на похожесть, и в обоих случаях граница проходит через серую зону, где отличить безобидное от опасного можно только по дополнительным данным. Чем чувствительнее настроен порог, тем больше ложных сигналов; чем выше порог, тем выше риск пропустить реальное событие.
Отсюда практический вывод: качество системы определяется не количеством найденного, а соотношением найденного и потраченного на проверку времени. Если на один значимый инцидент приходится сотня безобидных, специалист перестаёт реагировать на сигналы вообще. Снижение ложных срабатываний — работа не разовая, а постоянная: правила и пороги приходится пересматривать по мере изменения процессов.
Требования к данным и приватности (152-ФЗ)
Любая модель живёт на данных, а данные о работниках в России регулируются 152-ФЗ «О персональных данных». Это означает, что обработка должна иметь законное основание, ограниченный состав и понятные сроки хранения, а сотрудников нужно уведомить и получить их согласие там, где оно требуется. Аналитика поведения здесь не исключение: снимки экрана, поисковые запросы и хронология действий относятся к персональным данным.
Формальный подход — «пропишем в политике и на том закончим» — не работает. Согласие должно быть информированным: человек понимает, какие данные о нём собирают, зачем и сколько они хранятся. Дополнительно стоит предусмотреть разграничение доступа: не каждый руководитель должен видеть всё, что видит служба безопасности. Рекомендуем согласовать состав документов с юристом — универсального шаблона, подходящего любой компании, здесь нет.
Второй аспект приватности — качество обучающих данных. Модель, обученная на чужих обезличенных массивах, может не подходить для вашей среды: у вас другая структура ролей, другие программы, другой график. Попытка применить готовую модель без адаптации даёт либо много шума, либо много пропусков.
Почему решение остаётся за человеком
Автоматические действия по инциденту заманчивы: заблокировать учётную запись, изолировать станцию, закрыть доступ к ресурсу. Но каждое такое действие имеет цену. Ошибочная блокировка учётной записи главного бухгалтера в день закрытия квартала останавливает работу подразделения. Изоляция станции разработчика прерывает сборку. Именно поэтому в зрелых практиках автоматика выполняет только те действия, которые заранее одобрены и обратимы.
Сценарий, в котором автономный ИИ сам изучает инфраструктуру и принимает решения без участия человека, в разборах обычно относят к теоретическим и одновременно небезопасным. Причина проста: система без контекста и без ответственности может действовать быстро, но не может отвечать за последствия. Человек в контуре принятия решений — не формальность, а механизм, который соединяет скорость модели с пониманием бизнеса.
Практика выглядит так: модель формирует сигнал с обоснованием, специалист сверяет его с контекстом, фиксирует вывод, и только после этого запускаются действия — либо автоматические по регламенту, либо ручные. Такой порядок медленнее полной автоматизации, но именно он делает результат пригодным для внутренних проверок и объяснений.
Что важно учесть
ИИ-детект не гарантирует обнаружение угрозы. Он сужает область поиска, поэтому пропуск сигнала остаётся возможным, а политика безопасности должна исходить из этого допущения, а не из обещания «модель найдёт всё».
Сравнение подходов: правила, машинное обучение и гибридная схема
Выбор между «только правила» и «только модель» обычно искусственный. На практике зрелые системы сочетают оба подхода, а разница между ними — в том, где какая логика применяется. Таблица ниже показывает, как отличается поведение этих схем по ключевым параметрам эксплуатации.
Сравнивать их стоит не по точности в вакууме, а по стоимости владения: сколько усилий уходит на настройку, кто отвечает за поддержание качества и что произойдёт, когда процессы в компании изменятся. Именно эти параметры определяют, приживётся ли инструмент через год после запуска.
Сравнение подходов: правила, машинное обучение и гибридная схема
| Критерий | Правила и сигнатуры | Машинное обучение | Гибридная схема |
|---|---|---|---|
| Что лежит в основе | Описанное вручную условие | Закономерности, найденные на исторических данных | Правила для известного, модель для неизвестного |
| Реакция на новую угрозу | Только после того, как правило добавили | Возможна, если угроза похожа на прошлые образцы | Правило закрывает известное, модель ищет отклонение |
| Объяснимость решения | Высокая: видно сработавшее условие | Зависит от модели, требует усилий | Объяснение есть у правила, у сигнала модели — с оговоркой |
| Уровень шума | Растёт вместе с числом правил и исключений | Ниже, если данные и пороги подобраны | Ниже при корректной приоритизации |
| Требования к данным | Минимальные | Высокие: нужна разметка и представительная выборка | Высокие для модели, минимальные для правил |
| Стоимость настройки | Низкая на старте, растёт со временем | Высокая на старте: сбор данных, обучение, валидация | Выше средней, распределена по этапам |
| Риск при ошибке | Пропуск того, чего нет в правилах | Ложные сигналы и пропуск непохожего | Снижается за счёт перекрёстной проверки |
Вывод из таблицы прикладной: чистые правила быстро устаревают, чистая модель плохо объясняет свои выводы, а рабочая конфигурация почти всегда гибридная. Для чувствительных данных оставляют точные правила, для поиска неизвестного — модель, а между ними ставят человека, который разбирает спорные случаи.
Как выбрать решение: практические критерии
Выбор средства с ИИ-детектом редко сводится к сравнению списка функций. Продукты отличаются тем, на каких данных их обучали, как они объясняют сигнал и насколько глубоко встраиваются в существующие процессы. Ниже — критерии, которые стоит проверить до покупки, а не после внедрения.
- Источники данных и их совместимость. Проверьте, какие системы решение умеет читать: SIEM, DLP, журналы ОС, корпоративные приложения. Если интегрировать придётся вручную, оцените стоимость этих работ.
- Объяснимость сигнала. Запросите демонстрацию карточки инцидента. Видно ли, какие признаки сработали, какие события связаны, что было до и после? Если ответ — «модель так решила», ценность сигнала для расследования низкая.
- Управление порогами и исключениями. Можно ли настроить чувствительность под разные группы сотрудников или типы ресурсов? Насколько легко добавить исключение, не отключив правило целиком?
- Требования к обучающим данным. Нужна ли разметка силами заказчика, сколько её и кто будет поддерживать? Ответ «модель уже обучена на всём» на практике означает, что адаптации не будет.
- Рамки автоматических действий. Какие действия система может выполнить сама, обратимы ли они, есть ли журнал и подтверждение человеком?
- Документы по персональным данным. Как решение помогает выполнить требования 152-ФЗ: уведомление сотрудников, согласие, сроки хранения, разграничение доступа.
- Сопровождение после запуска. Кто пересматривает политики через полгода, когда изменятся процессы и появятся новые классы документов?
Отдельно стоит проверить, как решение ведёт себя на пилотном участке. Две-три недели на реальном потоке показывают больше, чем описание возможностей: станет видно соотношение значимых сигналов и шума, а также реальную нагрузку на специалиста, который эти сигналы разбирает.
Практические рекомендации по внедрению
Внедрение ИИ-детекта проваливается не из-за слабой модели, а из-за отсутствия процесса вокруг неё. Организации, которые получают результат, начинают с малого участка и заранее договариваются, как будет устроена проверка сигналов. Ниже — шаги, которые стоит пройти по порядку.
Порядок шагов принципиален: если сначала включить детект, а потом договариваться о том, кто разбирает сигналы, поток уведомлений быстро перерастёт возможности службы. Начинать с организационной части проще и дешевле, чем разбирать последствия.
- Определите один сценарий, а не пять. Начните с задачи, где потери уже измеримы и понятны: например, контроль передачи документов с персональными данными или выявление нежелательного ПО. Расширять охват стоит после того, как первый сценарий заработал.
- Опишите, кто разбирает сигналы. У каждого инцидента должен быть владелец и срок реакции. Без этого новые уведомления просто добавятся к прежнему потоку.
- Зафиксируйте порог значимости. Договоритесь, какие события поднимаются как инцидент, какие копятся в отчёте, а какие игнорируются. Порог стоит пересматривать по накопленной статистике, а не по ощущениям.
- Подготовьте документы по персональным данным. Уведомление сотрудников, согласие там, где требуется, положение о мониторинге, регламент доступа к данным. Согласуйте состав с юристом до запуска, а не после первого вопроса от сотрудника.
- Проверьте объяснимость на реальном потоке. Возьмите несколько настоящих инцидентов и посмотрите, сможет ли специалист по карточке восстановить хронологию без обращения к другим системам.
- Оставьте автоматике только обратимое. Автоматическая блокировка снимается сложно, автоматическое уведомление — легко. Начинайте со второго.
- Назначьте точку пересмотра. Через три-шесть месяцев после запуска политики и пороги нужно пересмотреть: изменятся процессы, появятся новые типы данных, накопится статистика ошибок.
Что будет с ИИ в ИБ дальше
Направление остаётся одним из устойчивых трендов, и причина не в моде, а в арифметике: объём событий растёт быстрее, чем число специалистов. Автоматизация мониторинга и анализа событий уже стала нормой в крупных компаниях, а в среднем сегменте постепенно переходит из категории «экзотика» в обычную закупку. Параллельно растёт запрос на людей, которые умеют работать с моделями детекта: настроить, проверить, объяснить результат.
Второе направление — объяснимость. Чем больше решений делегируется моделям, тем важнее становится возможность показать основание. Это касается и внутренних проверок, и разговоров с сотрудниками, и требований регуляторов к обработке данных. Системы, которые не умеют объяснить сигнал, будут проигрывать не по точности, а по доверию.
Третье — сближение технического и поведенческого контуров. Инцидент на периметре и странное действие внутри сети редко существуют отдельно: чаще это две части одного эпизода. Решения, которые показывают обе картины в одной хронологии, дают специалисту то, чего не даёт ни один источник по отдельности. Именно в этой точке аналитика цифровой активности сотрудников становится полноправной частью ИБ-контура.
И четвёртое: границы автоматизации будут определяться не техническими возможностями, а ответственностью. Пока действие системы влечёт последствия для людей и бизнес-процессов, окончательное решение останется за человеком. Меняться будет скорость подготовки этого решения, а не сама модель ответственности.
Частые ошибки при работе с ИИ в информационной безопасности
Большинство неудачных внедрений выглядят похоже. Компания покупает инструмент с обещанием «умного детекта», включает его на весь контур и через месяц получает поток событий, который никто не разбирает. Разберём ошибки, которые ведут к такому результату.
Общая черта этих ошибок одна: инструмент рассматривают как замену процессу, а не как его часть. Избежать их помогает короткая проверка перед закупкой — она приведена в чек-листе ниже.
- Ожидание, что модель заменит специалиста. Модель сокращает рутину, но не берёт на себя ответственность. Планировать штат нужно исходя из того, что проверка останется, пусть и на меньшем объёме.
- Запуск без базовой линии. Модель, не знающая типового поведения пользователей и групп, будет считать аномалией всё необычное. Сначала нужно накопить данные о норме, потом включать поиск отклонений.
- Отсутствие владельца у инцидента. Сигналы без ответственного превращаются в отчёт, который никто не открывает. Каждое правило должно иметь владельца и срок реакции.
- Правила вместо контекста. Попытка описать словарём ключевых слов каждую ситуацию заканчивается сотнями исключений. Для смысловых категорий лучше подходит классификация, а не перечисление.
- Забытые документы по персональным данным. Мониторинг запускают технически, а уведомление и согласие оформляют «потом». Это создаёт риск, который перевешивает пользу от внедрения.
- Оценка людей по одному показателю. Рейтинг по количеству инцидентов или по проценту активного времени не описывает работу человека. Такие выводы стоит делать только в связке с задачами и результатами.
- Отсутствие пересмотра настроек. Политика, настроенная год назад, описывает процессы годичной давности. Без регулярного пересмотра качество детекта постепенно падает.
Чек-лист: готова ли компания к ИИ-детекту
Список ниже помогает быстро проверить, закрыты ли организационные условия до запуска. Если по какому-то пункту ответ отрицательный, начинать с технической части рано: без владельца, порогов и документов детект превратится в поток сигналов, который никто не разбирает.
Отмечать пункты стоит честно и вместе с теми, кто будет эти сигналы разбирать. Согласие службы безопасности и руководителя подразделения на этом этапе важнее, чем выбор конкретного продукта.
- Сценарий выбран и измерим. Есть конкретная задача и понятный признак, по которому будет видно, что она решается.
- Владелец инцидента назначен. Известно, кто разбирает сигналы, в какой срок и что делает с результатом.
- Пороги значимости зафиксированы. Есть договорённость, что считается инцидентом, что попадает в отчёт, что игнорируется.
- Данные о норме собраны. Система накопила достаточно истории, чтобы отличать типовое поведение от отклонения.
- Документы по 152-ФЗ готовы. Уведомление, согласие, положение о мониторинге и регламент доступа оформлены и согласованы.
- Объяснимость проверена. По карточке инцидента можно восстановить хронологию и понять основание сигнала.
- Автоматика ограничена обратимыми действиями. Блокировки и изоляция выполняются только по одобренному регламенту.
- Точка пересмотра назначена. Известно, когда и кто пересмотрит политики и пороги по накопленной статистике.
Итоги: что запомнить о применении ИИ в информационной безопасности
Применение искусственного интеллекта в информационной безопасности даёт эффект в узком, но важном месте — там, где нужно быстро отсортировать большой поток событий и найти отклонение, не описанное правилом. Машинное обучение работает с файлами, трафиком, документами и поведением пользователей, а выигрыш проявляется не в «умных отчётах», а в сокращении ручной рутины и времени до реакции на значимый сигнал.
Ограничения у подхода системные: качество зависит от обучающих данных, ложные срабатывания неизбежны, а работа с данными сотрудников регулируется 152-ФЗ и требует уведомления и согласия. Поэтому зрелая схема включает человека в контуре принятия решений, а автоматике оставляет только обратимое и заранее одобренное.
Именно в такой связке аналитика цифровой активности сотрудников становится частью ИБ-контура: она даёт ту картину рабочего места, которой не хватает при разборе инцидента. Начинать стоит с одного измеримого сценария, владельца сигналов и понятных порогов — и пересматривать настройки по мере изменения процессов.
FAQ
Чем применение искусственного интеллекта в информационной безопасности отличается от классических правил?
Правило срабатывает на заранее описанное условие, а модель ищет закономерности в данных и оценивает степень отклонения. Правило предсказуемо и легко объяснимо, модель лучше работает с новыми ситуациями, но требует обучающих данных и хуже раскрывает основания вывода. На практике оба подхода используют вместе.
Может ли ИИ заменить специалиста по безопасности?
Нет. Он сокращает объём ручной работы и помогает приоритизировать события, но не берёт на себя ответственность за решение. Финальную оценку по-прежнему делает человек, потому что модель не знает контекста, которого нет в данных.
Почему ИИ ошибается и как снизить число ложных срабатываний?
Ошибки возникают из-за неполных или нерепрезентативных обучающих данных и из-за выбранного порога чувствительности. Снизить их помогает адаптация модели под среду заказчика, регулярный пересмотр порогов и исключений, а также проверка сигналов на реальном потоке до внедрения.
Как ИИ применяется в DLP-системах?
Чаще всего для классификации документов и для контекстных политик. Система определяет тип файла автоматически и оценивает ситуацию целиком — роль отправителя, канал, адресата, обычную практику отдела. Это снижает количество ложных инцидентов по сравнению с правилами на ключевых словах.
Законно ли использовать ИИ для мониторинга активности сотрудников?
Да, при соблюдении требований 152-ФЗ: у обработки должно быть законное основание, сотрудников нужно уведомить и получить согласие там, где оно требуется, а доступ к данным — разграничить по ролям. Состав документов стоит согласовать с юристом.
С чего начать внедрение ИИ в ИБ небольшой компании?
С одного измеримого сценария, владельца сигналов и понятных порогов значимости. Дальше стоит проверить объяснимость инцидентов на реальном потоке и запустить пилот на ограниченном участке, а политики пересмотреть через несколько месяцев.
19 ноября | 15:00
ВЕБИНАР ОТ ТОТАЛЬНОГО КОНТРОЛЯ К ЭКОЛОГИЧНОЙ СИСТЕМЕ САМООРГАНИЗАЦИИ КОМАНДЫ
Расскажем о том, как экологично внедрить систему мониторинга и извлечь из этого пользу не только руководителям, но и сотрудникам.
Вас ждут взрывные идеи и ценные подарки, регистрируйтесь!
Оцените, насколько полезной была статья
Попробовать бесплатно ИНСАЙДЕР
Протестируйте систему мониторинга за 14 дней с поддержкой нашего специалиста и узнайте, чем заняты ваши сотрудники на самом деле.
Оставить комментарий